VLA · SKILL REPRESENTATION
오픈도메인 멀티모달 자기주도 인공지능 기술 개발
다양한 실제 로봇 작업에서 공유할 수 있는 skill을 학습하고, 이를 시각·언어 맥락과 연결하는 학습 방법을 연구하였습니다. 실제 로봇 기반 Skill Foundation Model에서 Multimodal Skill Representation으로 확장해 온 과정을 소개합니다.
정보통신기획평가원
Part 1
Skill Foundation Model
접촉이 많은 실제 로봇 작업에서 반복적으로 나타나는 동작을 skill로 학습하고, 이를 여러 작업의 행동 생성에 활용하는 Skill Foundation Model (SFM)을 구성하였습니다. 이 단계에서는 실제 로봇 데이터를 기반으로 skill 표현과 정책을 학습하고, 작업 수행 성공률을 통해 활용 효과를 평가하였습니다.
Motivation & Skill Concept
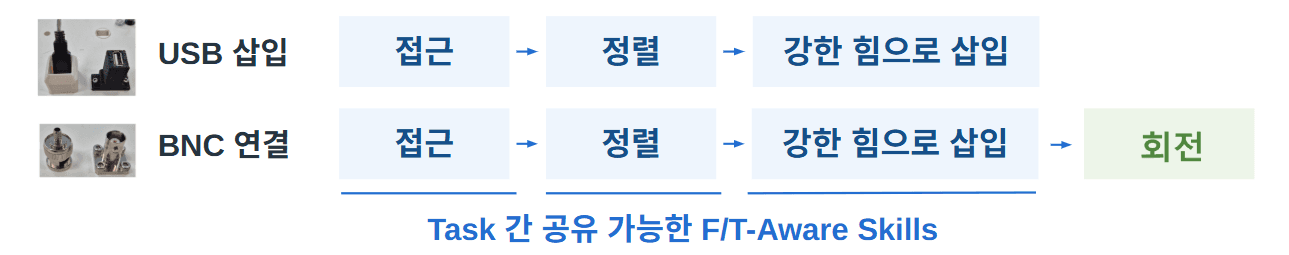
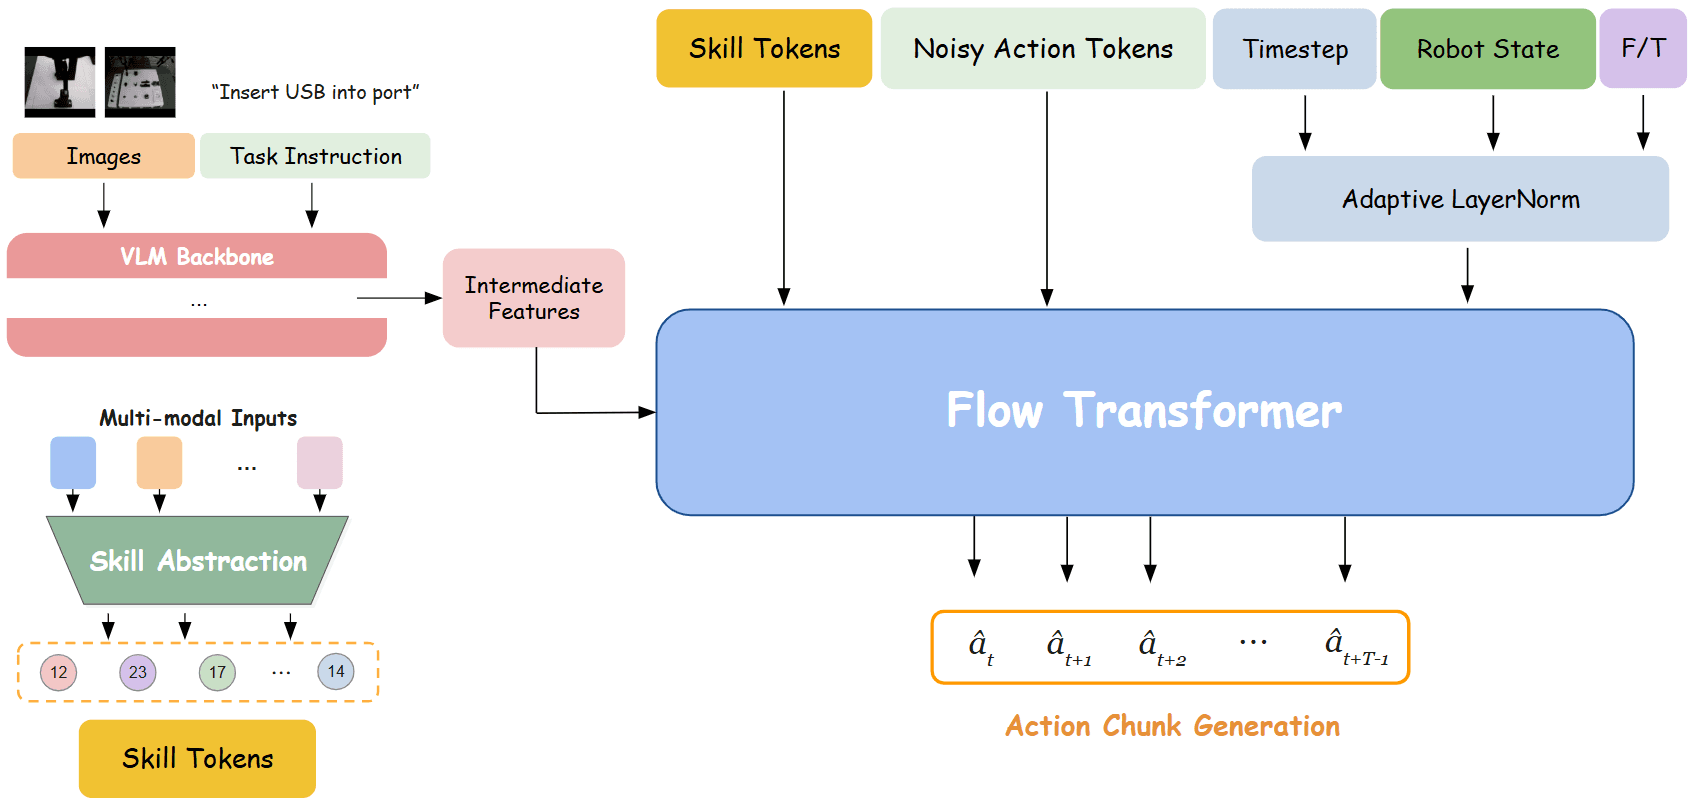
USB를 포트에 삽입하거나 BNC 커넥터를 연결하는 작업은 서로 다른 목표를 갖지만, 대상에 접근하고 위치를 정렬한 뒤 접촉력을 가해 삽입하는 과정이 공통으로 나타나고, BNC 연결에는 이후 회전 동작이 추가됩니다. 이처럼 여러 작업에서 재사용할 수 있는 동작 패턴을 skill로 표현하고, 작업 간에 공유하는 것을 목표로 하였습니다. 나아가, 정밀 체결 작업에서는 동작의 궤적과 함께 접촉 및 힘의 변화도 중요합니다. 따라서, F/T 정보를 고려하는 skill을 연구의 방향으로 설정하고, 초기 SFM에서는 행동에서 추출한 skill과 F/T 관측값을 정책의 입력으로 활용하였습니다.
Skill Representation & Policy Learning
Stage 1 — Skill Representation
QueST의 자기지도 학습 접근을 차용해 32 step의 sequence를 skill encoder에 입력하여 압축된 8개의 skill 표현을 얻고, skill decoder가 원래의 action sequence를 복원하도록 학습하였습니다. 이 자기지도 학습 구조를 통해 별도의 명시적인 skill 구분 없이도 행동에 담긴 반복적인 패턴을 표현할 수 있도록 하였습니다.
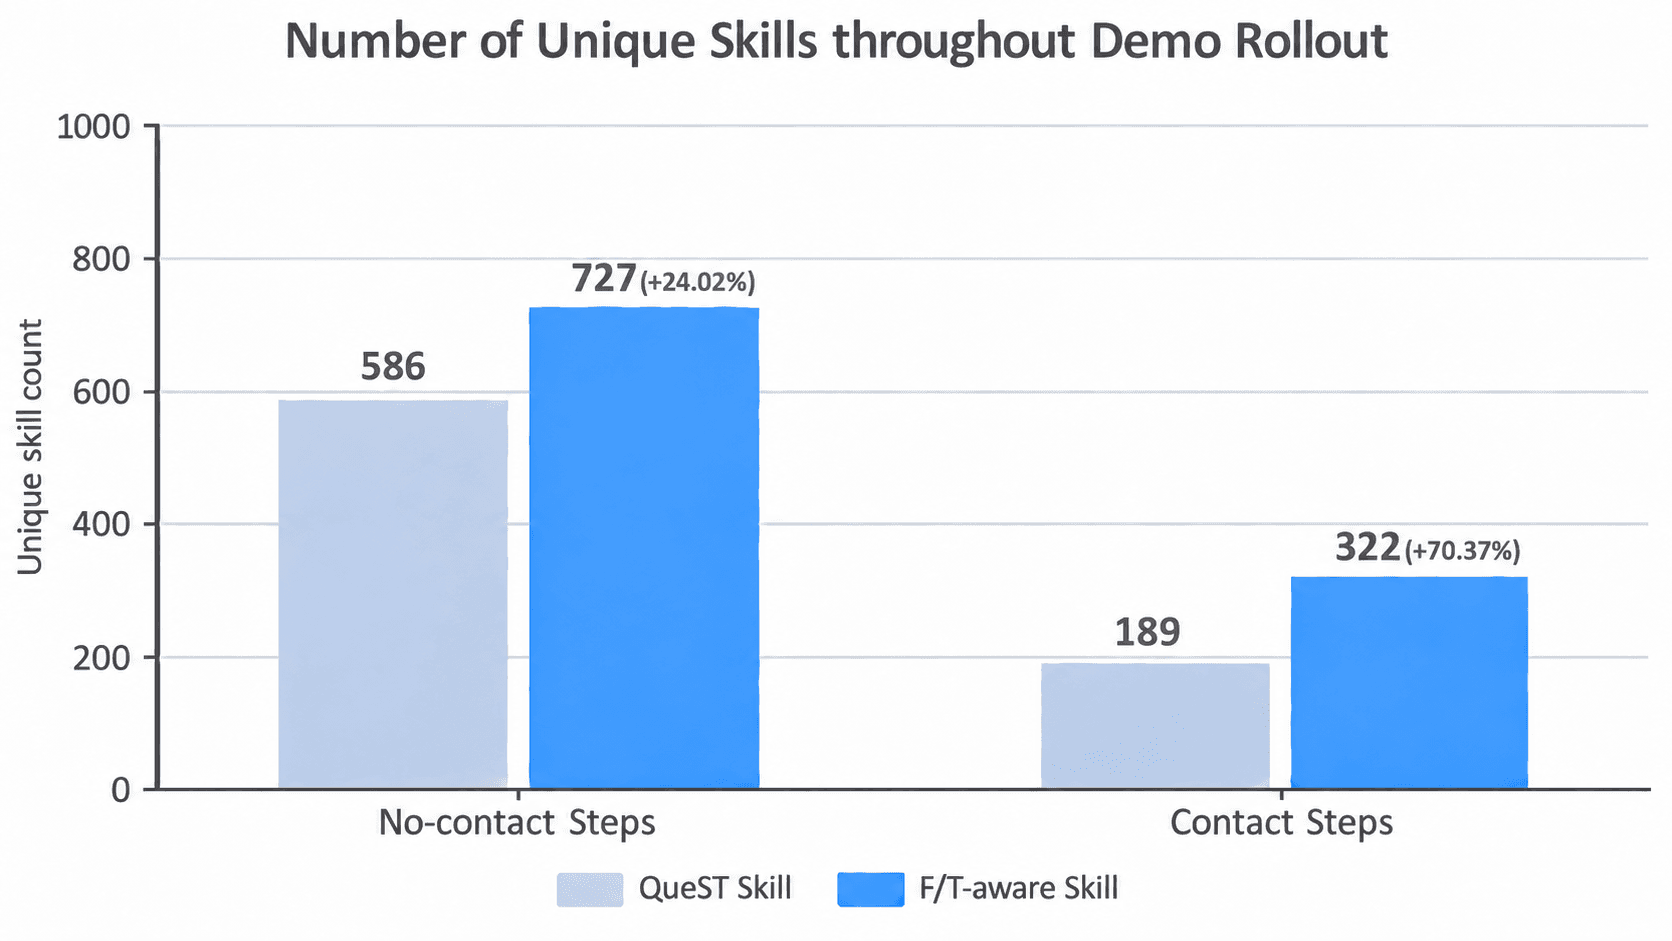
이러한 압축 표현은 반복되는 동작 패턴을 공통된 skill로 요약할 수 있다는 장점이 있지만, 표현이 지나치게 coarse해지면 정밀한 조작에 필요한 미세한 action 차이를 충분히 구분하기 어려울 수 있습니다. 이에 F/T 신호를 AdaLN 기반의 조건으로 skill encoder에 주입하여, 접촉 상태에 따라 skill 표현의 세밀함을 조절하고자 하였습니다. F/T 값이 0에 가깝게 안정적으로 유지되는 단순 이동 구간에서는 유사한 action들을 상대적으로 coarse하게 묶고, 접촉으로 F/T 신호가 급격히 변화하는 구간에서는 미세한 action 차이를 더 fine-grained하게 표현하도록 유도하는 것을 목표로 하였습니다.
접촉 구간에서 skill 표현이 더 세분화되는지를 간접적으로 살펴보기 위해, skill encoder 학습을 마친 뒤 학습에 사용한 데이터를 가지고 skill을 생성하고, 접촉 구간과 비접촉 구간에서 사용된 고유 skill 수를 각각 집계하였습니다. QueST와 비교했을 때 F/T-aware Skill의 고유 skill 수는 비접촉 구간에서 586개에서 727개로 약 24.1% 증가하였으며, 접촉 구간에서는 189개에서 322개로 약 70.4% 증가하였습니다. 접촉 구간에서 상대적으로 더 큰 증가율이 나타난 결과는 F/T 정보를 통해 접촉 관련 동작을 더 세분화하려는 설계 의도와 부합하는 경향으로 해석하였습니다.
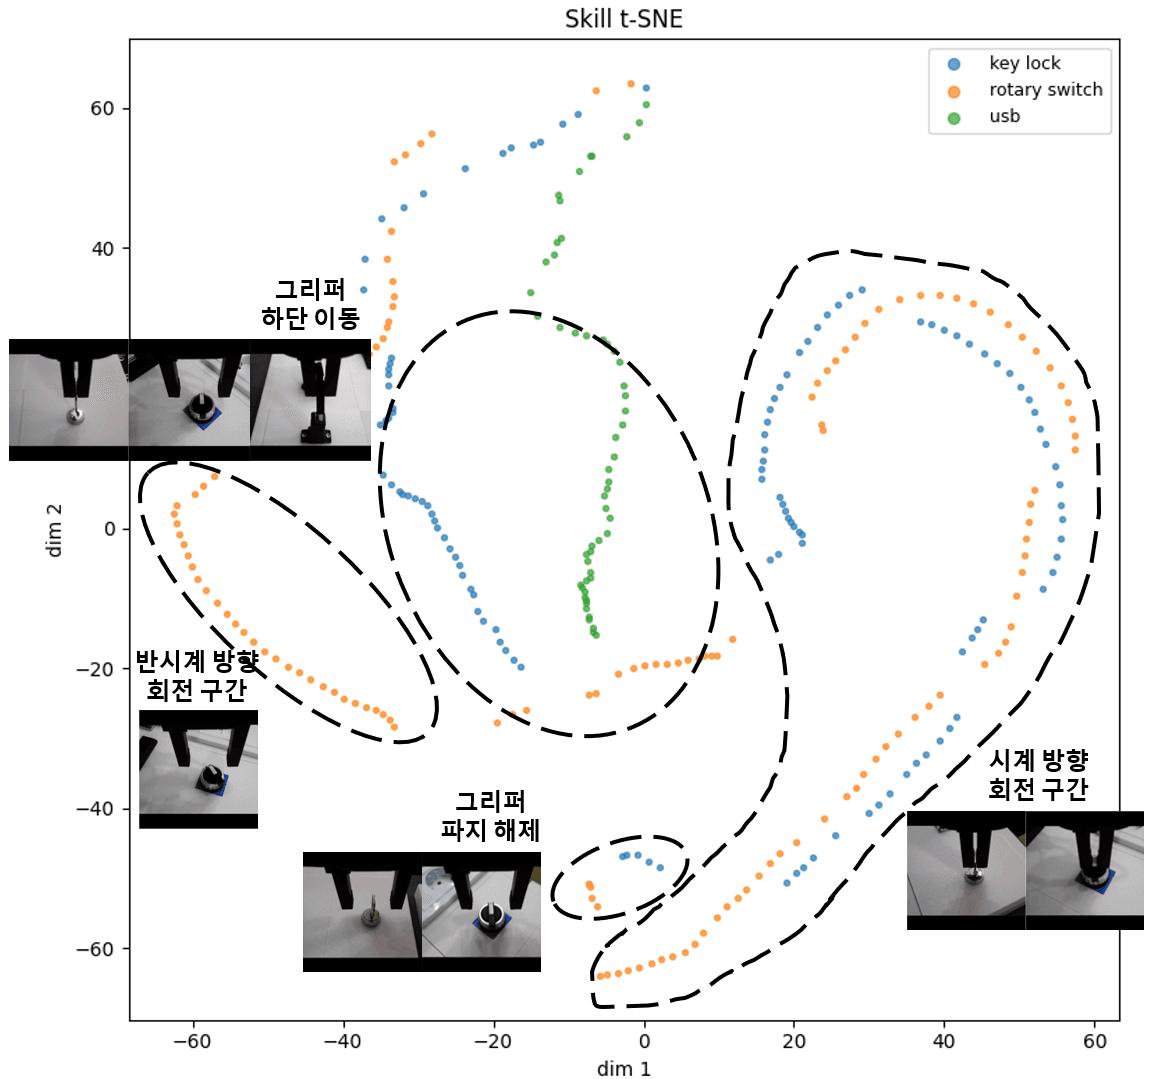
학습된 skill을 t-SNE로 시각화하여, 서로 다른 세 가지 작업에 포함된 그리퍼 하강, 회전, 파지 해제 등의 동작을 정성적으로 비교하였습니다. 그 결과, 작업이 다르더라도 의미적으로 유사한 동작에 해당하는 skill이 시각화 공간에서 인접하게 분포하는 경향을 확인하였습니다.
Stage 2 — Policy Learning
학습한 skill tokens를 행동 생성의 조건으로 활용하였습니다. Flower VLA를 베이스 모델로 활용하여 카메라 이미지와 task instruction에서 얻은 VLM feature를 Flow Transformer에 전달하고, robot state와 F/T 관측값도 함께 반영하여 action chunk를 생성하도록 구성하였습니다. 이를 통해 현재 장면과 작업 지시, 로봇의 상태를 학습된 skill과 연결합니다.
Real-Robot Evaluation
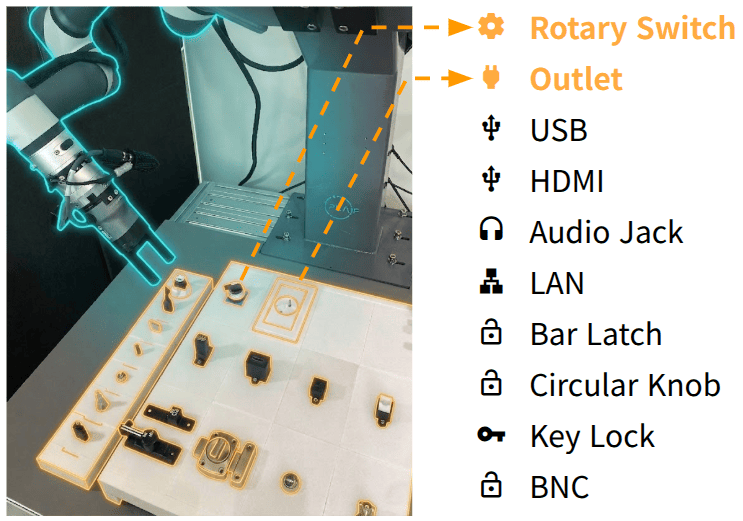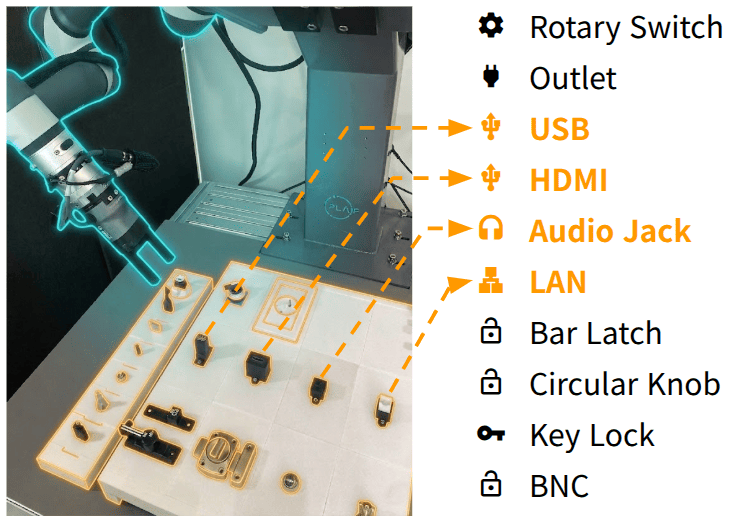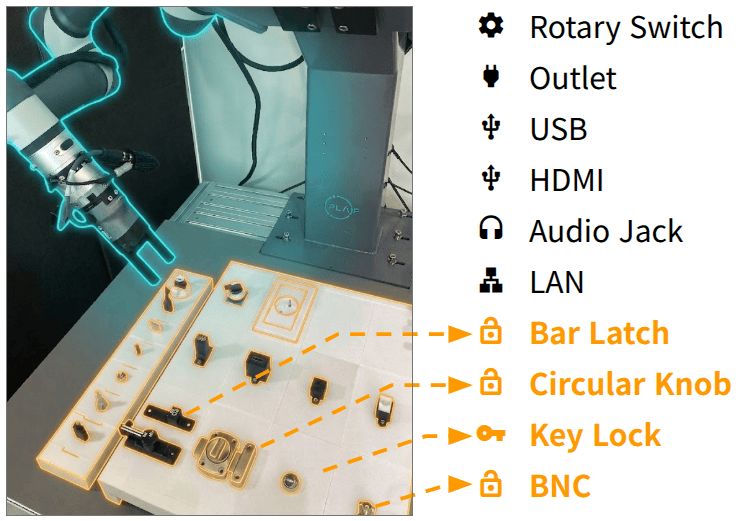
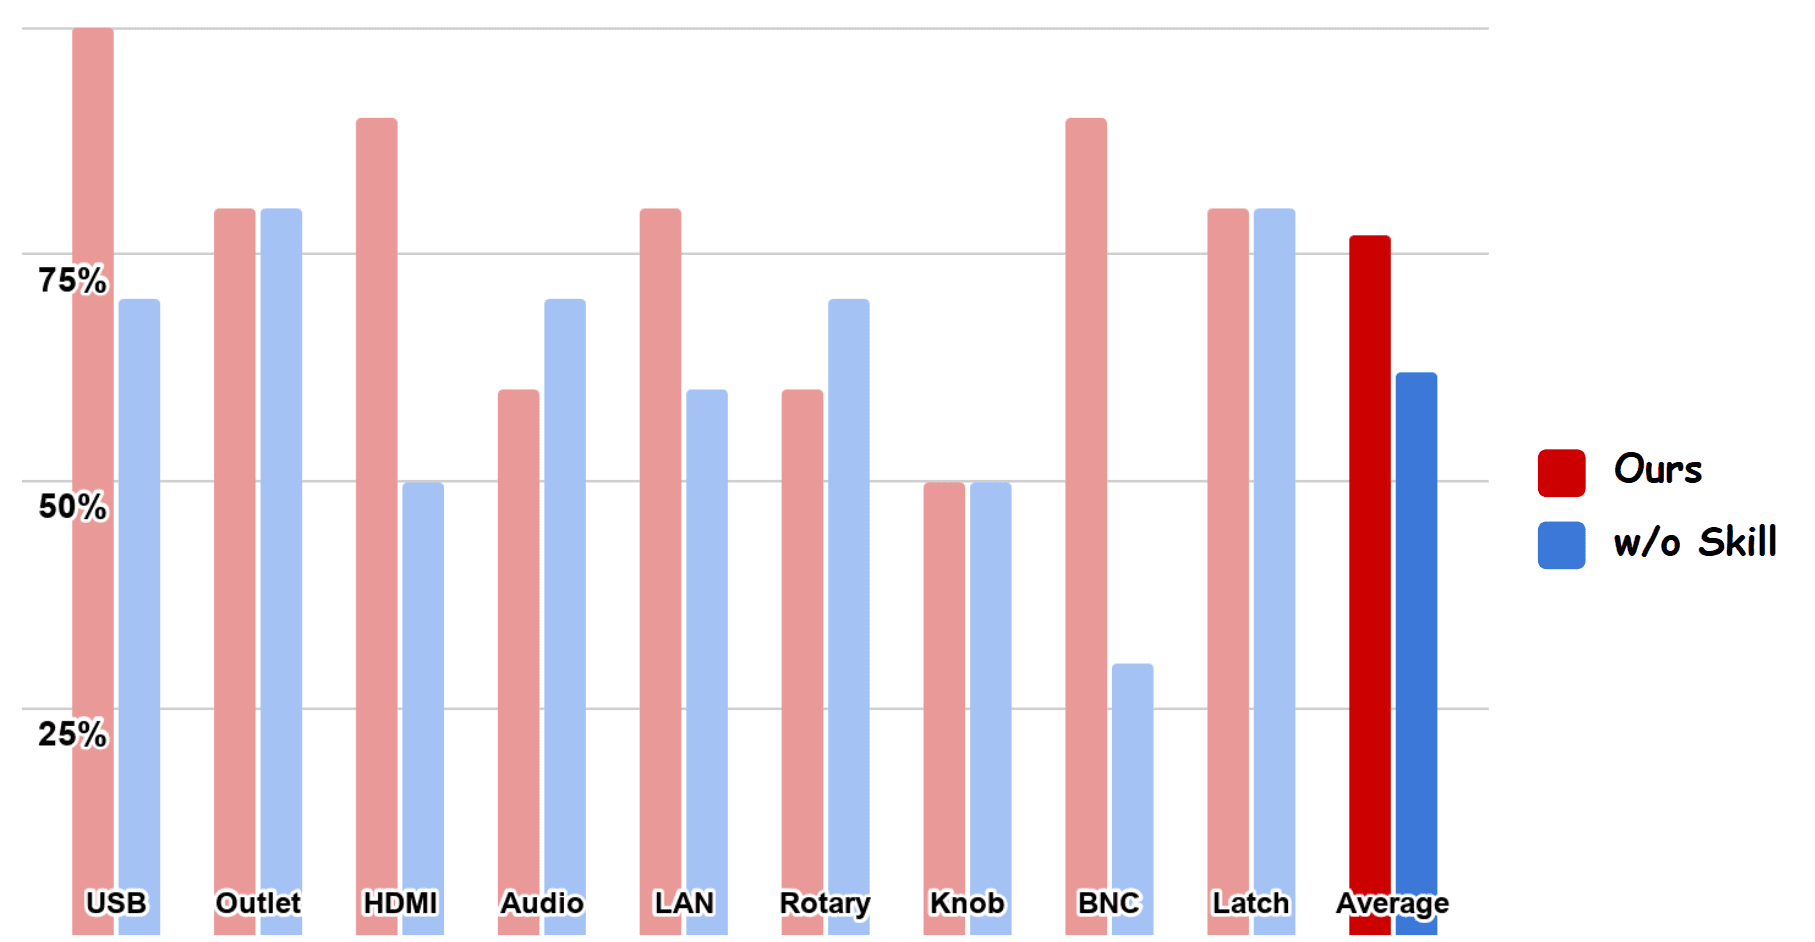
학습 및 평가 세팅은 다양한 접촉이 요구되는 9가지의 작업(USB, Outlet, HDMI, Audio, LAN, Rotary, Knob, BNC, Latch)으로 구성하였습니다. 데이터는 작업별로 중복되지 않은 5개 위치에서 각각 10회의 시연을 수집하여 총 450개 episode로 구성하였고, 평가는 각 작업 당 10회씩 수행하였습니다. 평가 결과 skill을 사용하는 SFM의 평균 성공률은 76.7%로, skill을 사용하지 않는 baseline의 성공률인 62.2%보다 높았습니다.
Robot Platforms & Infrastructure- Demonstrations
- 450
- 5 positions × 9 tasks × 10 demos
- Evaluation
- 90 trials
- 9 tasks × 10 trials
- SFM
- 76.7%
- 평균 성공률
- w/o Skill
- 62.2%
- 평균 성공률
Demo
Part 2
Multimodal Skill Representation
앞선 실험을 통해 재사용 가능한 skill 표현을 행동 생성에 활용하는 효과를 확인하였습니다. 이를 바탕으로 현재의 시각적 상황과 작업 의도를 함께 반영할 수 있도록, skill 표현을 멀티모달 정보와 연결하는 방향으로 연구를 확장하였습니다.
Motivation
기존처럼 action reconstruction loss만으로 학습한 skill encoder는 연속된 행동을 압축하고, 복원에 필요한 반복적인 동작 패턴을 표현하는 데에는 효과적입니다. 그러나 이러한 학습만으로는 조작 대상이나 작업 의도와 같은 semantic 정보를 skill에 명시적으로 담기 어렵습니다. 이에 로봇이 어떤 동작을 수행하는지와 함께, 어떤 대상을 향해 어떤 의도로 움직이는지를 표현하기 위해 시각·언어 정보를 skill 학습에 연결하고자 하였습니다. 시각 정보는 현재 장면과 조작 대상을, 언어 정보는 작업의 목표와 의미를 제공하므로, 행동 패턴을 현재 상황에 맞게 해석하는 데 활용할 수 있습니다.
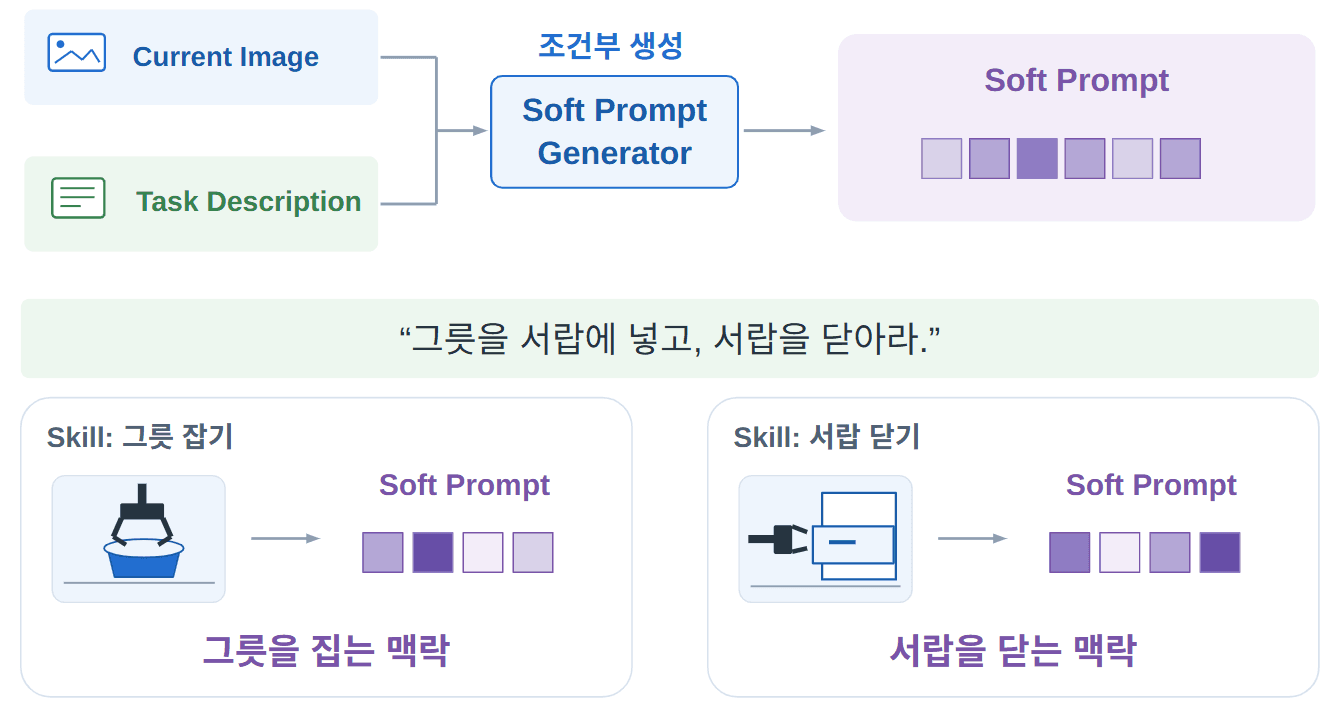
이를 위해 필요한 것은 현재 수행 중인 skill의 문맥입니다. 그러나 데이터에는 episode 전체를 설명하는 task description만 있고, 세부 skill에 대한 annotation은 없는 경우가 많습니다. 예를 들어 “그릇을 서랍에 넣고, 서랍을 닫아라”라는 지시는 있어도, 각 구간을 “그릇 집기”, “서랍에 놓기”, “서랍 닫기”로 나눈 설명은 제공되지 않습니다.
설령 이러한 세부 문맥을 설명하는 텍스트가 제공되더라도, 각 문맥이 시작되고 끝나는 지점을 사람이 step 단위로 별도 annotation하지 않으면 텍스트와 행동 사이의 정확한 시간적 대응을 알기 어렵습니다. 또한 현재의 skill 학습에서는 demonstration에서 연속된 32 step을 무작위로 추출하여 사용하므로, 하나의 학습 구간이 반드시 단일 문맥에만 대응하지는 않습니다. 예를 들어 그릇을 서랍에 놓는 동작에서 서랍을 닫는 동작으로 넘어가는 구간처럼, 여러 문맥에 걸친 행동이나 문맥 사이의 전환 동작이 함께 포함될 수 있습니다.
Conditional Soft Prompts
이러한 annotation의 한계를 고려하여, 현재 이미지와 task description에 조건화된 학습 가능한 soft prompt를 도입하였습니다. CoCoOp의 구조를 활용하여 soft prompt generator가 현재 장면에 맞는 prompt embedding을 생성하고, 이를 task description과 함께 text encoder에 전달하여 전체 작업 지시에 현재 수행 중인 동작의 문맥을 반영하도록 하였습니다.
같은 작업 지시가 주어지더라도 그릇을 집는 구간과 서랍을 닫는 구간, 그리고 그 사이의 전환 구간에서 필요한 문맥은 달라집니다. Conditional soft prompt는 세부 문맥이나 구간 경계를 별도로 annotation하지 않고도, 현재 관측에 따라 달라지는 표현으로 이러한 차이를 반영하도록 설계하였습니다.
Multimodal SFM Architecture
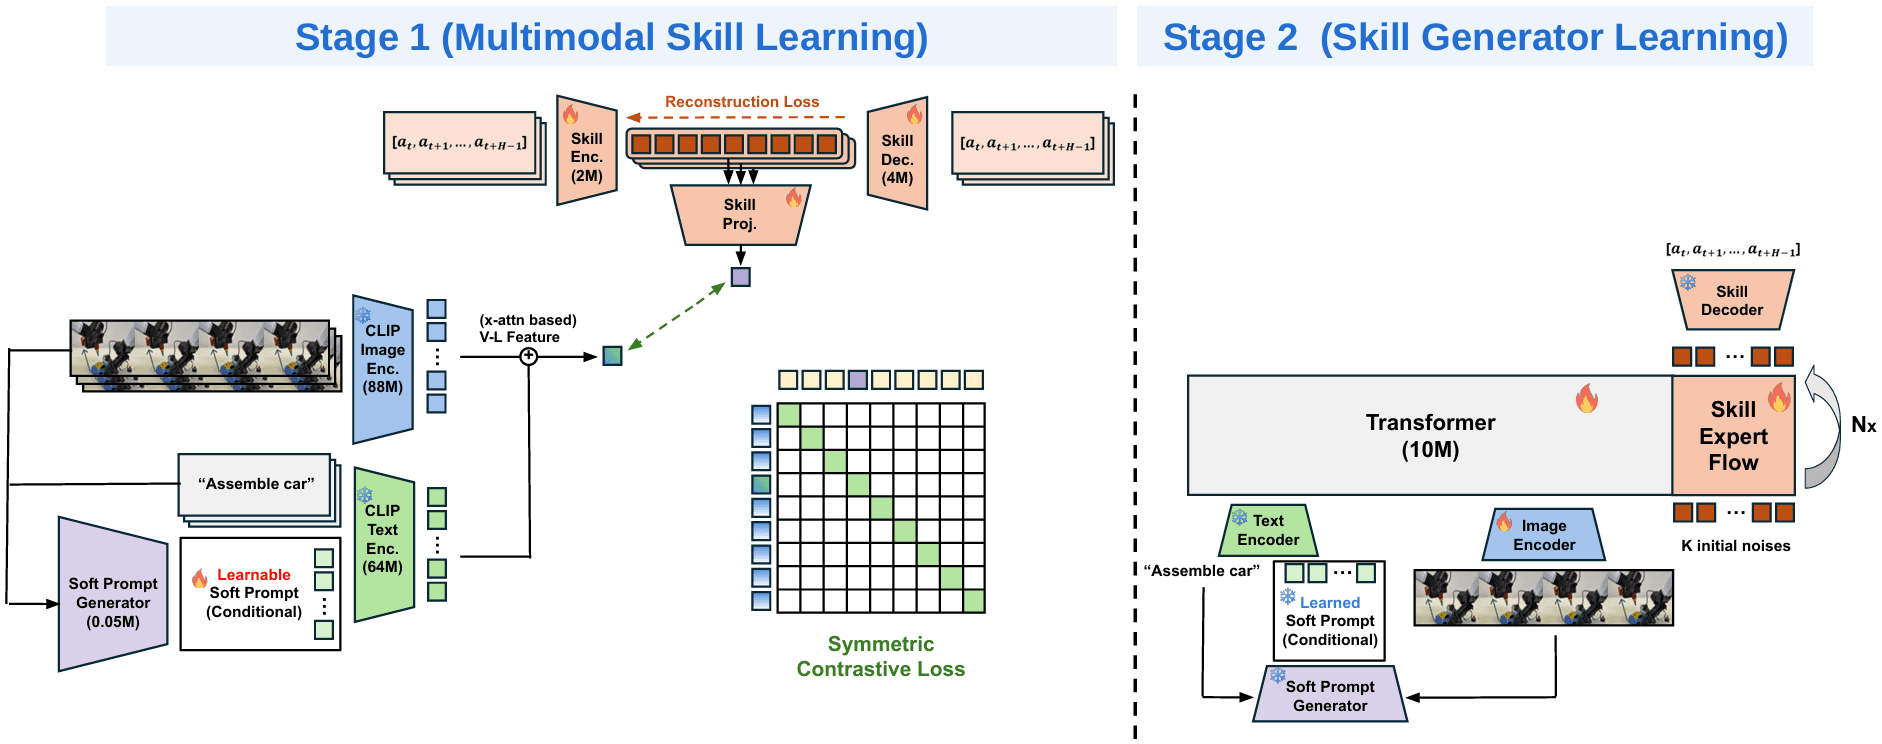
Stage 1 — Multimodal Skill Learning
Action sequence를 복원하는 reconstruction loss로 skill encoder와 decoder를 학습하는 동시에, skill 표현을 시각·언어 특징과 정렬하였습니다. 이때 앞서 설명한 conditional soft prompt를 task description과 함께 CLIP text encoder에 입력하여, 작업 지시와 함께 현재 장면과 동작의 문맥을 반영한 언어 특징을 얻도록 하였습니다. 이렇게 얻은 언어 특징과 CLIP image encoder의 시각 특징을 BooST-style로 결합하고, 투영된 skill 표현과 V-L feature 사이에 symmetric contrastive loss를 적용하였습니다.
이 단계에서는 CLIP image·text encoder를 고정하고, skill encoder·decoder와 projection, soft prompt generator를 함께 학습하였습니다. 멀티모달 정렬의 학습 신호를 soft prompt generator에도 전달하여, 현재 행동 구간과 연결되는 문맥을 표현하도록 하였습니다. 이를 통해 별도의 skill 문맥 annotation 없이도 행동 패턴과 시각·언어 의미 정보를 함께 담는 skill을 학습하고자 하였습니다.
Stage 2 — Skill Generator Learning
이미지와 언어 조건을 입력받는 Transformer 및 flow 기반 skill expert가 skill 표현을 생성하도록 학습하였습니다. 생성된 skill은 1단계에서 학습한 decoder를 거쳐 action sequence로 복원됩니다. 이때 skill decoder와 학습된 soft prompt generator를 고정하여, 학습한 표현을 실제 행동 생성에 활용하는 skill generator를 학습하였습니다.
Experiments & Analysis
LIBERO-LONG Evaluation
LIBERO-LONG에서 학습 및 평가를 수행한 결과, Multimodal SFM의 성공률은 87.2%로 나타났습니다. Action-only skill 모델인 QueST의 72.8%와 비교하여 14.4%p 향상된 결과를 보였습니다.
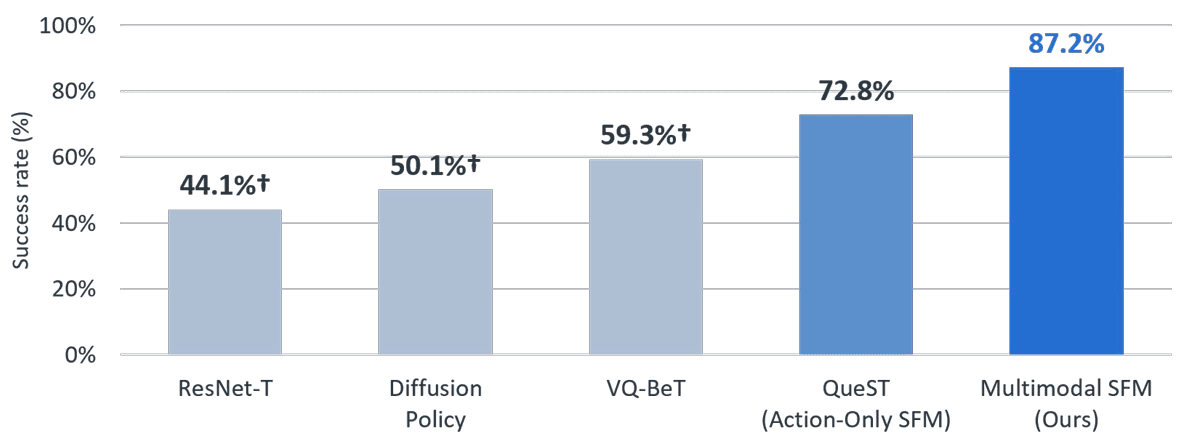
† QueST: Self-Supervised Skill Abstractions for Learning Continuous Control (NeurIPS 2024)에 보고된 성공률을 인용한 값입니다.
Ablation Study
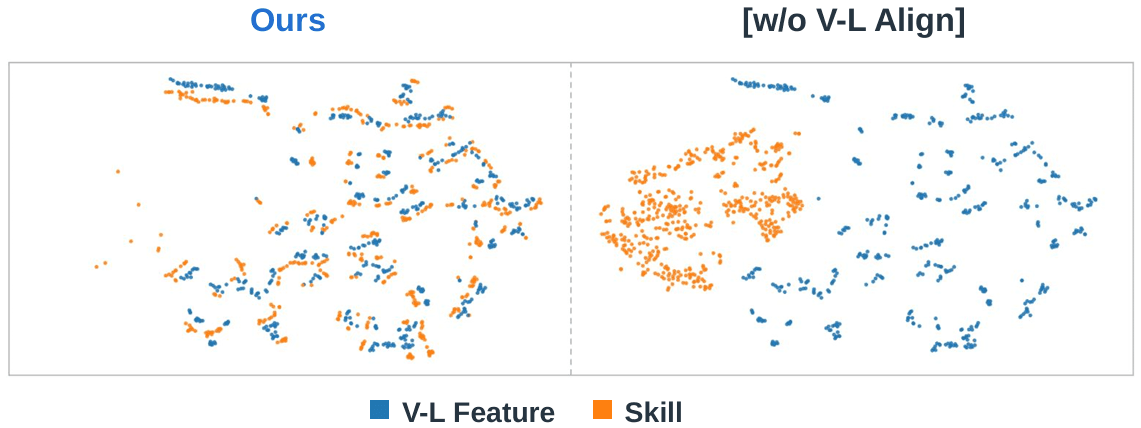
Soft prompt, language alignment, vision-language alignment, skill 표현에 대한 ablation study를 진행하였습니다. w/o L Align은 시각 특징만으로 skill을 정렬하는 설정이며, w/o V-L Align은 멀티모달 정렬 없이 행동 복원으로 skill을 학습하는 설정입니다. w/o Skill에서는 action sequence를 직접 생성합니다.
Soft prompt를 제거하는 경우 성공률이 4.8%p 낮아졌으며, V-L alignment와 skill을 제거한 설정에서는 각각 18.4%p, 20.8%p 낮아졌습니다. 이 실험에서는 skill 표현과 멀티모달 정렬을 함께 사용하는 설정이 가장 높은 성공률을 보였습니다.
| Setting | Success Rate | Ours 대비 |
|---|---|---|
| Multimodal SFM (Ours) | 87.2% | — |
| w/o Soft Prompt | 82.4% | −4.8%p |
| w/o Language Align | 83.6% | −3.6%p |
| w/o V-L Align | 68.8% | −18.4%p |
| w/o Skill | 66.4% | −20.8%p |
t-SNE Analysis
V-L Align을 적용한 모델과 이를 제거한 모델의 표현 분포를 t-SNE로 비교하였습니다. Ours에서는 skill과 V-L feature가 같은 영역에 함께 분포하는 양상을 보였으며, w/o V-L Align에서는 두 표현이 분리되어 나타났습니다. 이를 통해 skill embedding에 시각·언어의 semantic 정보가 반영되는 경향을 정성적으로 확인하였습니다.
Role of Soft Prompt
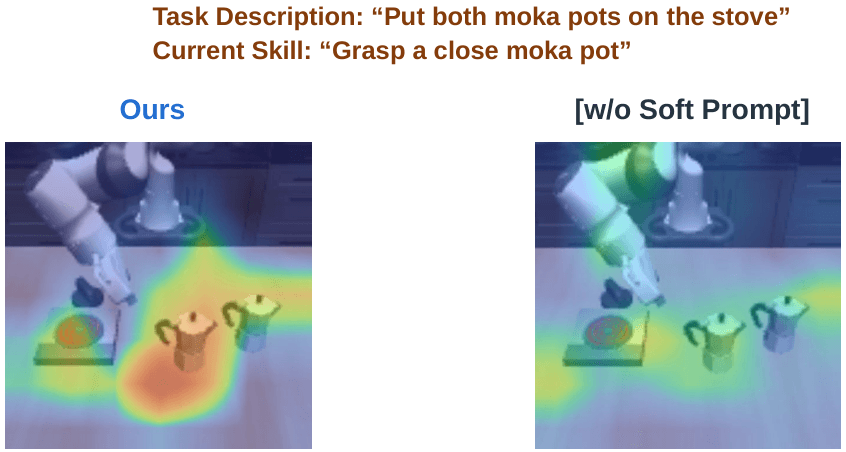
“Put both moka pots on the stove”라는 전체 작업 지시 아래에서, 현재 수행하는 동작이 가까운 moka pot을 집는 상황의 attention을 비교하였습니다. Soft prompt를 사용하는 모델은 현재 조작 대상에 더 집중하는 양상을 보였으며, 제거한 설정은 전체 작업과 관련된 영역에 주의를 분산하는 양상을 보였습니다. 이를 통해 현재 skill의 문맥을 반영하는 soft prompt의 역할을 정성적으로 살펴보았습니다.