REINFORCEMENT LEARNING · AUTONOMY
강화학습 기반 드론 이상 탐지 및 이상 행위 대응 기술
IMU 센서 왜곡 환경에서 목표 지점 이동과 호버링을 수행하는 강화학습 기반 드론 제어 연구
국가보안기술연구소
Simulation Environment
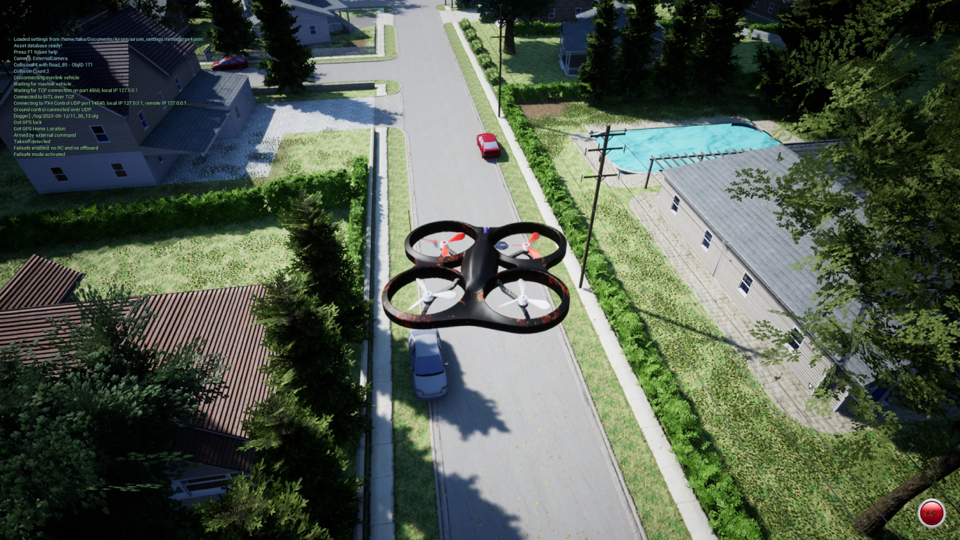
Microsoft Research의 AirSim을 기반으로 드론 비행 시뮬레이션 환경을 구성하였습니다. DJI F450 모델을 사용하여 센서 왜곡 수준과 제어 방식에 따른 강화학습 정책의 비행 성능을 평가하였습니다.
- Software
- Unreal Engine 4.27 · AirSim 1.8.1 · PX4 1.11.3 · Stable-Baselines3 2.0.0
- Drone
- DJI F450
- Inputs
- 자이로 센서, 가속 센서, GPS 위치 및 속도
- Distortion Targets
- 자이로 센서 · 가속 센서
- GPU
- RTX 2080 Ti 11GB × 4
Motivation
IMU의 선형가속도와 각속도는 드론의 움직임을 추정하고 비행을 제어하는 데 사용됩니다. 실제 비행에서는 기체 진동에 의한 측정 신호 왜곡이나 온도 변화에 따른 센서 bias가 발생할 수 있습니다. 부정확한 센서값은 위치·자세 추정에 오차를 만들고, 이를 바탕으로 이루어지는 제어에도 영향을 주어 목표 위치로의 이동이나 안정적인 호버링을 어렵게 할 수 있습니다.
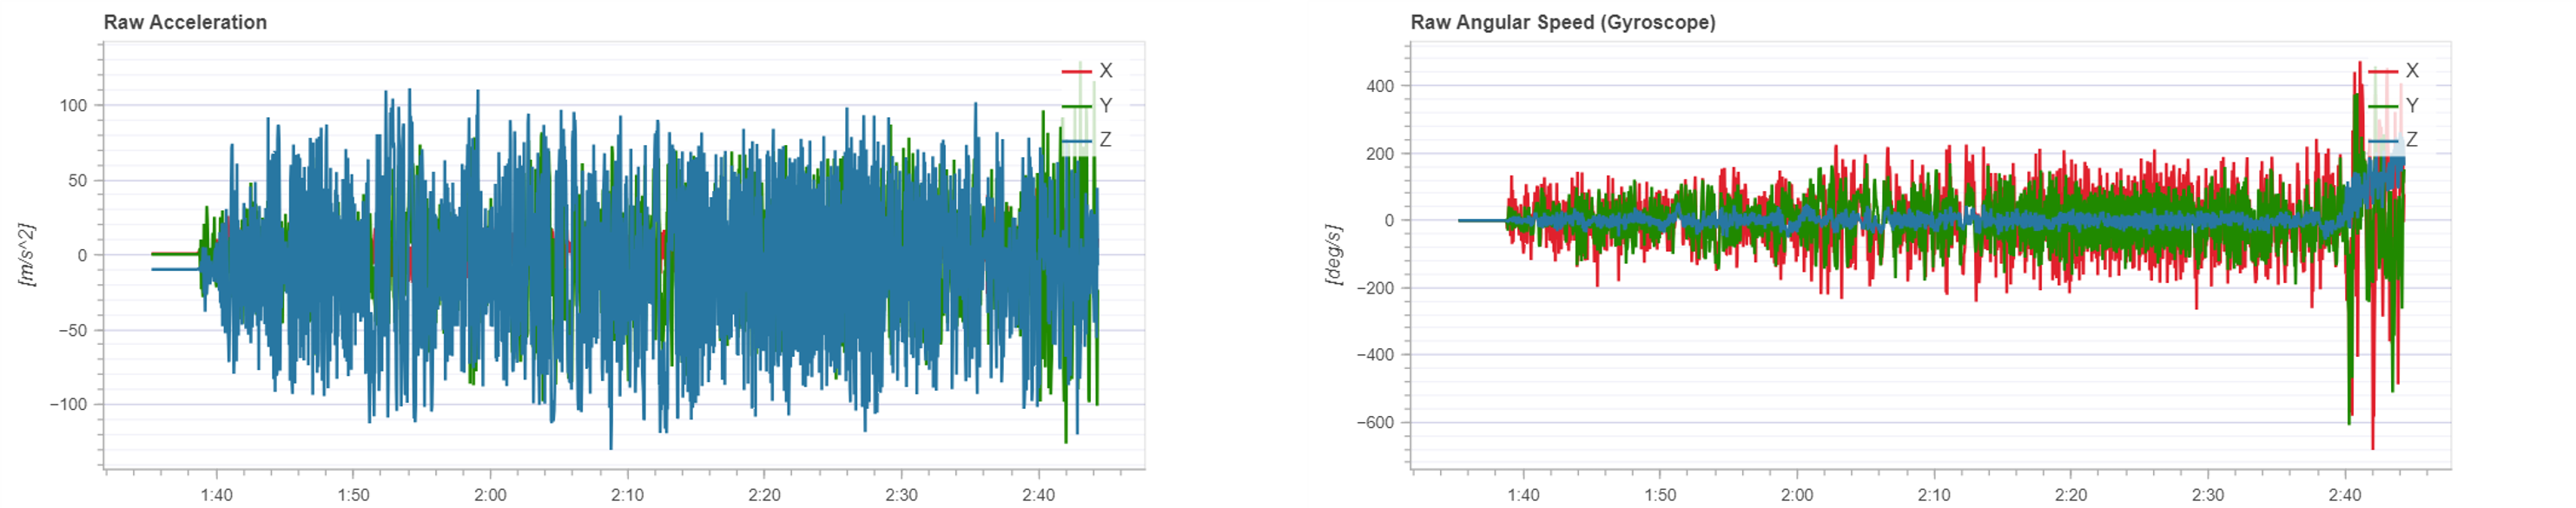
연구의 출발점은 PX4 Flight Review의 공개 비행 로그에서 확인한 실제 드론의 IMU 센서 왜곡 사례입니다. 첨부한 선형가속도와 각속도 데이터는 이곳에서 확인한 실제 왜곡값입니다. 이러한 상황에서도 목표 지점에 도달하고 위치를 유지할 수 있도록, 왜곡된 관측값에 대응하는 강화학습 기반 제어 정책을 연구하였습니다.
IMU Distortion Setup
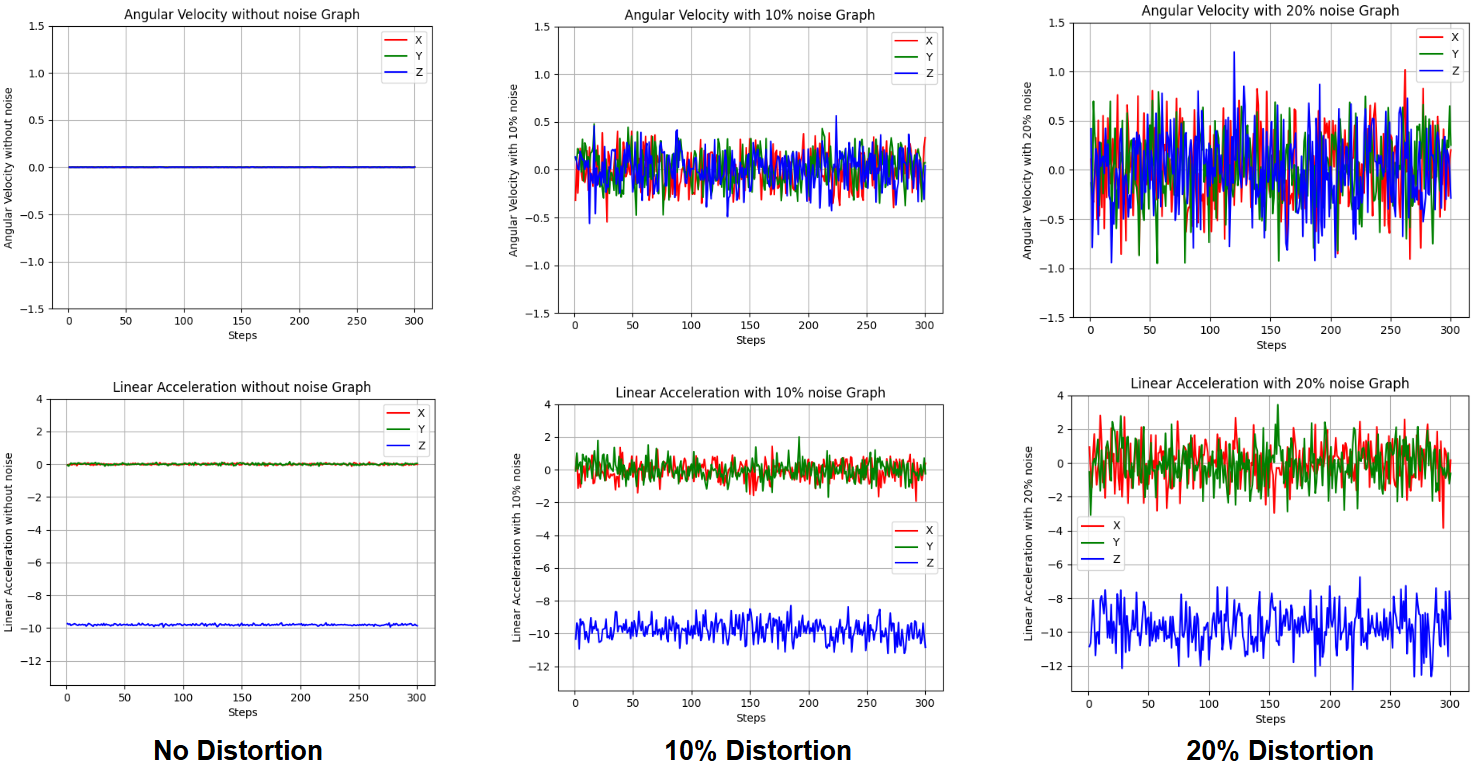
센서 왜곡을 재현하고 강도를 조절하기 위해, 현재 IMU에서 측정한 linear acceleration과 angular velocity에 정규분포에서 추출한 노이즈를 더하였습니다. 각 센서 신호의 최대 크기 기준값에 원하는 왜곡률을 곱해 표준편차를 정하고, 평균이 0인 정규분포에서 값을 샘플링하였습니다.
σ = p · M
εt ~ N(0, σ2)
x̃t = xt + εt
M은 센서 신호별 최대 크기 기준값, p는 왜곡률을 비율로 나타낸 값이며, σ는 주입할 노이즈의 표준편차입니다. 매 시점의 측정값에 샘플링한 노이즈를 더해 왜곡된 관측값을 생성합니다. 왜곡률은 이 기준값에 대해 일관되게 적용하므로, 서로 다른 왜곡 강도에서 정책의 동작을 비교할 수 있습니다.
MDP Formulation
- State
- 목표 지점 좌표, GPS 좌표 및 속도, 선형가속도, 각속도, orientation
- Reward
- 현재 위치에서 목표 지점까지의 거리에 따라 보상을 부여하였습니다.
Action Spaces
위치 명령부터 모터 출력까지, 제어 수준이 다른 아래 네 가지 행동 공간을 각각 구성하여 학습을 시도하였습니다. 각 설정에서 정책은 해당 범위의 연속적인 제어값을 선택합니다.
| Action | 제어 대상 | 선택 범위 (각 성분) |
|---|---|---|
| Position | x, y, z 위치 | −5 ~ +5 |
| Velocity | x, y, z 속도 | −1 ~ +1 |
| Angular Velocity | x, y, z 각속도 | −3.14 ~ +3.14 |
| Motor Control | 각 모터 출력 세기 | 0 ~ 1 |
Baseline Learning
먼저 IMU 왜곡이 없는 환경에서 10 m 떨어진 목표 지점으로 이동한 뒤, 해당 위치에서 호버링하는 기본 task를 학습하였습니다. 알고리즘은 Soft Actor-Critic (SAC)을 사용하였으며, actor와 두 개의 Q network를 각각 256차원 hidden layer 3개로 구성하였습니다.
Position-based Action
매우 쉽게 학습
약 100K steps 이내
Velocity-based Action
쉽게 학습
Angular Velocity based Action
많은 학습 시간 소요
Motor-control based Action
매우 많은 학습 시간 소요
약 10M steps
Position-based Action은 약 100K steps 이내에 rule-based 수준으로 기본 task를 학습한 반면, 모터 출력을 직접 결정하는 Motor-control-based Action은 약 10M steps가 필요하였습니다. 같은 목표에 대해서도 행동 공간에 따라 학습에 필요한 상호작용 규모가 크게 달라졌습니다.
Learning with IMU Distortion
센서 왜곡 환경에서는 Motor-control-based Action 세팅에서 동일한 SAC 알고리즘과 network 구조에 Hindsight Experience Replay (HER)를 추가하여 학습하였습니다. 처음부터 일정한 왜곡 수준을 적용했을 때 0–40% 조건에서는 학습이 가능했지만, 50% 이상의 높은 왜곡 조건에서는 학습에 어려움이 있었습니다.
이에 따라 낮은 왜곡 수준에서 시작해 점진적으로 난이도를 높이는 curriculum learning을 도입하였습니다. 각 단계의 최대 왜곡 수준을 X%로 두고, 학습 중 노출되는 왜곡 조건을 두 비율로 나누었습니다.
학습 노출의 50%
x% 왜곡
학습 노출의 50%
0% ~ x% 왜곡
절반은 현재 단계의 최대 왜곡 수준을 경험하고, 나머지 절반은 왜곡이 없는 조건부터 현재 수준까지의 범위를 경험하도록 구성하였습니다. 학습이 진행될수록 x를 높이면서도 이전의 낮은 왜곡 수준을 함께 제공하여, 더 어려운 조건에 적응하는 과정에서도 다양한 왜곡 수준을 지속적으로 경험하도록 하였습니다.
Results
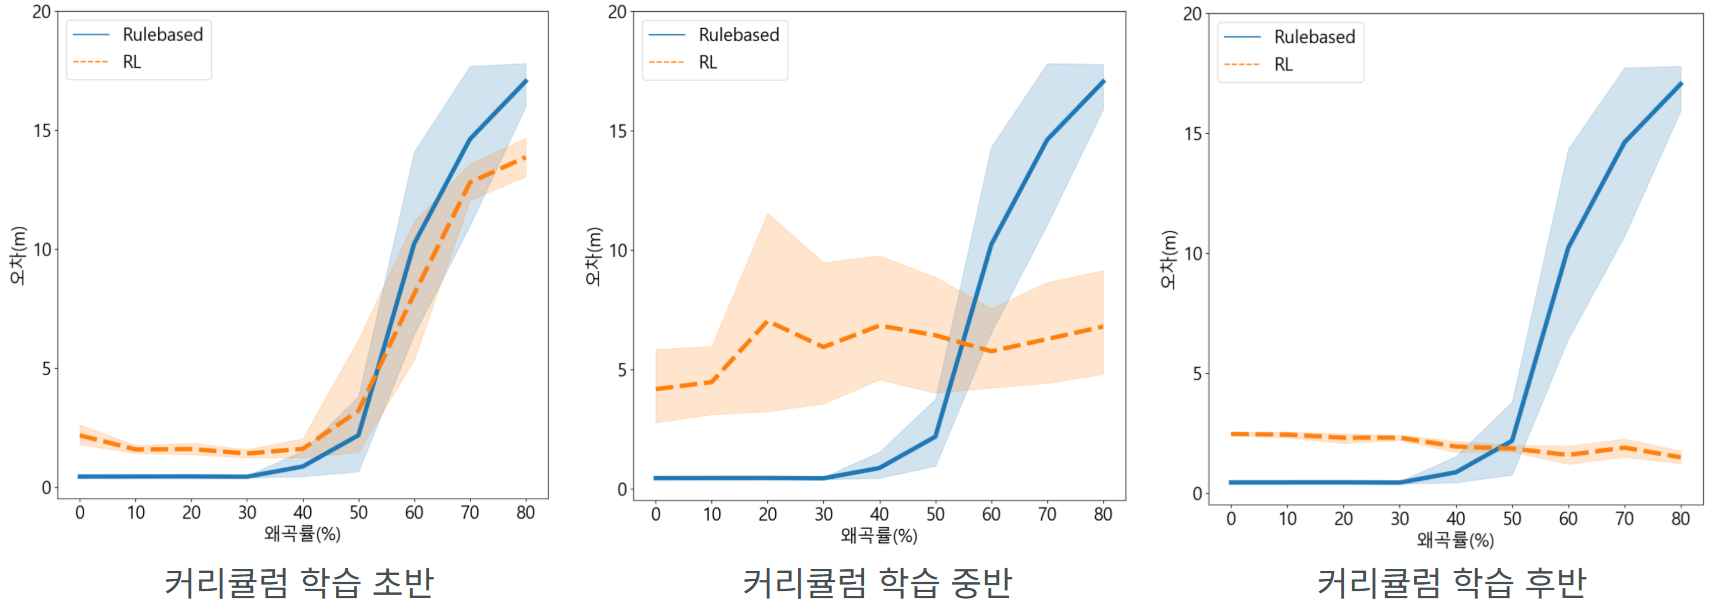
주어진 목표 위치로 이동하도록 하는 rule-based 제어를 기준으로, 왜곡 수준에 따른 목표 지점과의 위치 오차를 비교하였습니다. 커리큘럼 학습 초기에는 rule-based 방식과 비슷한 오차를 보였지만, 학습이 진행되면서 높은 왜곡 조건에서의 위치 오차가 줄어들었습니다.
학습 후반에는 80%의 높은 IMU 왜곡 수준에서도 비교적 낮고 안정적인 위치 오차를 유지하였습니다. 시뮬레이션에서 왜곡 강도를 점진적으로 높이고 이전 수준의 경험을 함께 제공하는 방식으로, 더 넓은 왜곡 범위에 대응하는 제어 정책을 학습할 수 있었습니다.